LLM local Mac : Gemma 4 E4B et 26B-A4B face à Qwen3.8-27B
Comparez Gemma 4 E4B, 26B-A4B et Qwen3.8-27B : architecture, benchmarks publiés, agents, outils, Intelligence Index et mémoire sur Mac.
 La rédaction POP Switcher · 5 min de lecture
Gemma 4 E4B, Gemma 4 26B-A4B et Qwen3.8-27B répondent à trois besoins différents sur Mac : conserver une configuration légère, accélérer le calcul avec un mélange d’experts ou préparer des missions de code plus exigeantes. Pour choisir un LLM local Mac, regardez ensemble le modèle, la mémoire disponible et le harnais qui exécutera ses outils.
Ce comparatif rapproche les fiches officielles et les évaluations publiées au 4 novembre 2026. Les chiffres des éditeurs décrivent leurs protocoles. Les mesures de débit sur un Mac donné constituent une autre information, à relever avec son moteur et sa quantification.
Trois architectures à comprendre
Le nom E4B désigne une taille effective. Google indique 4,5 milliards de paramètres effectifs, et 8 milliards en comptant les embeddings, ces tables de représentations numériques. Le 26B-A4B utilise un mélange d’experts, ou MoE : une partie des experts intervient à chaque étape de génération.
| Repère officiel | Gemma 4 E4B | Gemma 4 26B-A4B | Qwen3.8-27B |
|---|---|---|---|
| Paramètres | 4,5B effectifs ; 8B avec embeddings | 25,2B au total ; 3,8B actifs | 27B |
| Architecture | Modèle compact avec embeddings par couche | Mélange d’experts | Modèle dense, architecture hybride |
| Contexte annoncé | 128K tokens | 256K tokens | 262 144 tokens natifs |
| Orientation à examiner | Assistance et tâches courtes | Polyvalence et calcul partiellement activé | Code et missions agentiques |
Sources : fiche Google et fiche Qwen. Un token est une unité traitée par le modèle. La fenêtre annoncée représente une capacité de l’architecture ; votre configuration locale détermine le contexte réellement exploitable.
Code et raisonnement : lire les protocoles
Voici des résultats publiés par les équipes. Un pourcentage élevé indique un meilleur résultat sur l’évaluation concernée. Les environnements et les procédures propres aux éditeurs invitent à utiliser ces valeurs comme des repères.
| Évaluation publiée | Gemma 4 E4B, Google | Gemma 4 26B-A4B, Google | Qwen3.8-27B, Qwen |
|---|---|---|---|
| LiveCodeBench v6, code | 52,0 % | 77,1 % | 90,3 % |
| GPQA Diamond, raisonnement scientifique | 58,6 % | 82,3 % | 89,2 % |
| Tau2, moyenne de trois domaines | 42,2 % | 68,2 % | — |
Qwen publie aussi 61,7 % sur SWE-bench Pro et 73,0 % sur Terminal Bench 2.1. Son protocole SWE-bench Pro emploie le harnais Claude Code et un contexte de 256K. Ces résultats éclairent le travail sur un dépôt et au terminal ; ils dépendent de l’environnement d’évaluation. Le guide Code classique de POP explique comment un harnais organise les fichiers, les modifications et les contrôles.
Outils et agents : le modèle propose, le harnais agit
Google annonce des appels de fonctions natifs. Cette capacité aide le modèle à décrire une action structurée, comme rechercher un fichier ou consulter une documentation. Le harnais reçoit cette demande, applique ses permissions et transmet le résultat au modèle.
POP Switcher ajoute ses parcours par rôle et ses contrôles. Code classique prépare des extraits ciblés et utilise les diagnostics disponibles. The One peut coordonner des rôles autour d’un projet. Pour choisir entre les modèles, examinez donc aussi la qualité du format d’outil produit, la gestion des erreurs et la capacité à reprendre une tâche.
Un scénario utile consiste à demander une modification courte, exécuter les contrôles du projet, puis fournir une erreur à corriger. Conservez les mêmes fichiers et les mêmes consignes pour chaque modèle. Vous évaluerez ainsi le couple modèle-harnais sur votre travail.
Intelligence Index : conserver la même version
Dans les fiches Artificial Analysis consultées, Qwen3.8-27B en réglage xhigh obtient 20 dans l’Intelligence Index v5.0.1. Les fiches Gemma E4B et Gemma 26B-A4B affichent N/A pour l’index courant. La fiche Qwen décrit ses évaluations et son réglage.
Cette photographie datée donne une information précise. Pour établir un classement commun, il faut des scores issus de la même version de l’index, avec des réglages identifiés. Les résultats d’une ancienne grille peuvent être conservés dans leur contexte historique.
Sur Mac, regardez les poids et le contexte
Le nombre de paramètres actifs renseigne surtout le calcul effectué. Le stockage des poids et la mémoire de travail suivent leurs propres besoins. Exemple théorique : 25,2 milliards de paramètres à quatre bits représentent 12,6 Go décimaux pour les seuls poids. Les métadonnées, le cache de contexte, les buffers et macOS s’ajoutent à ce calcul simplifié. Le fichier quantifié réel donne un repère plus concret.
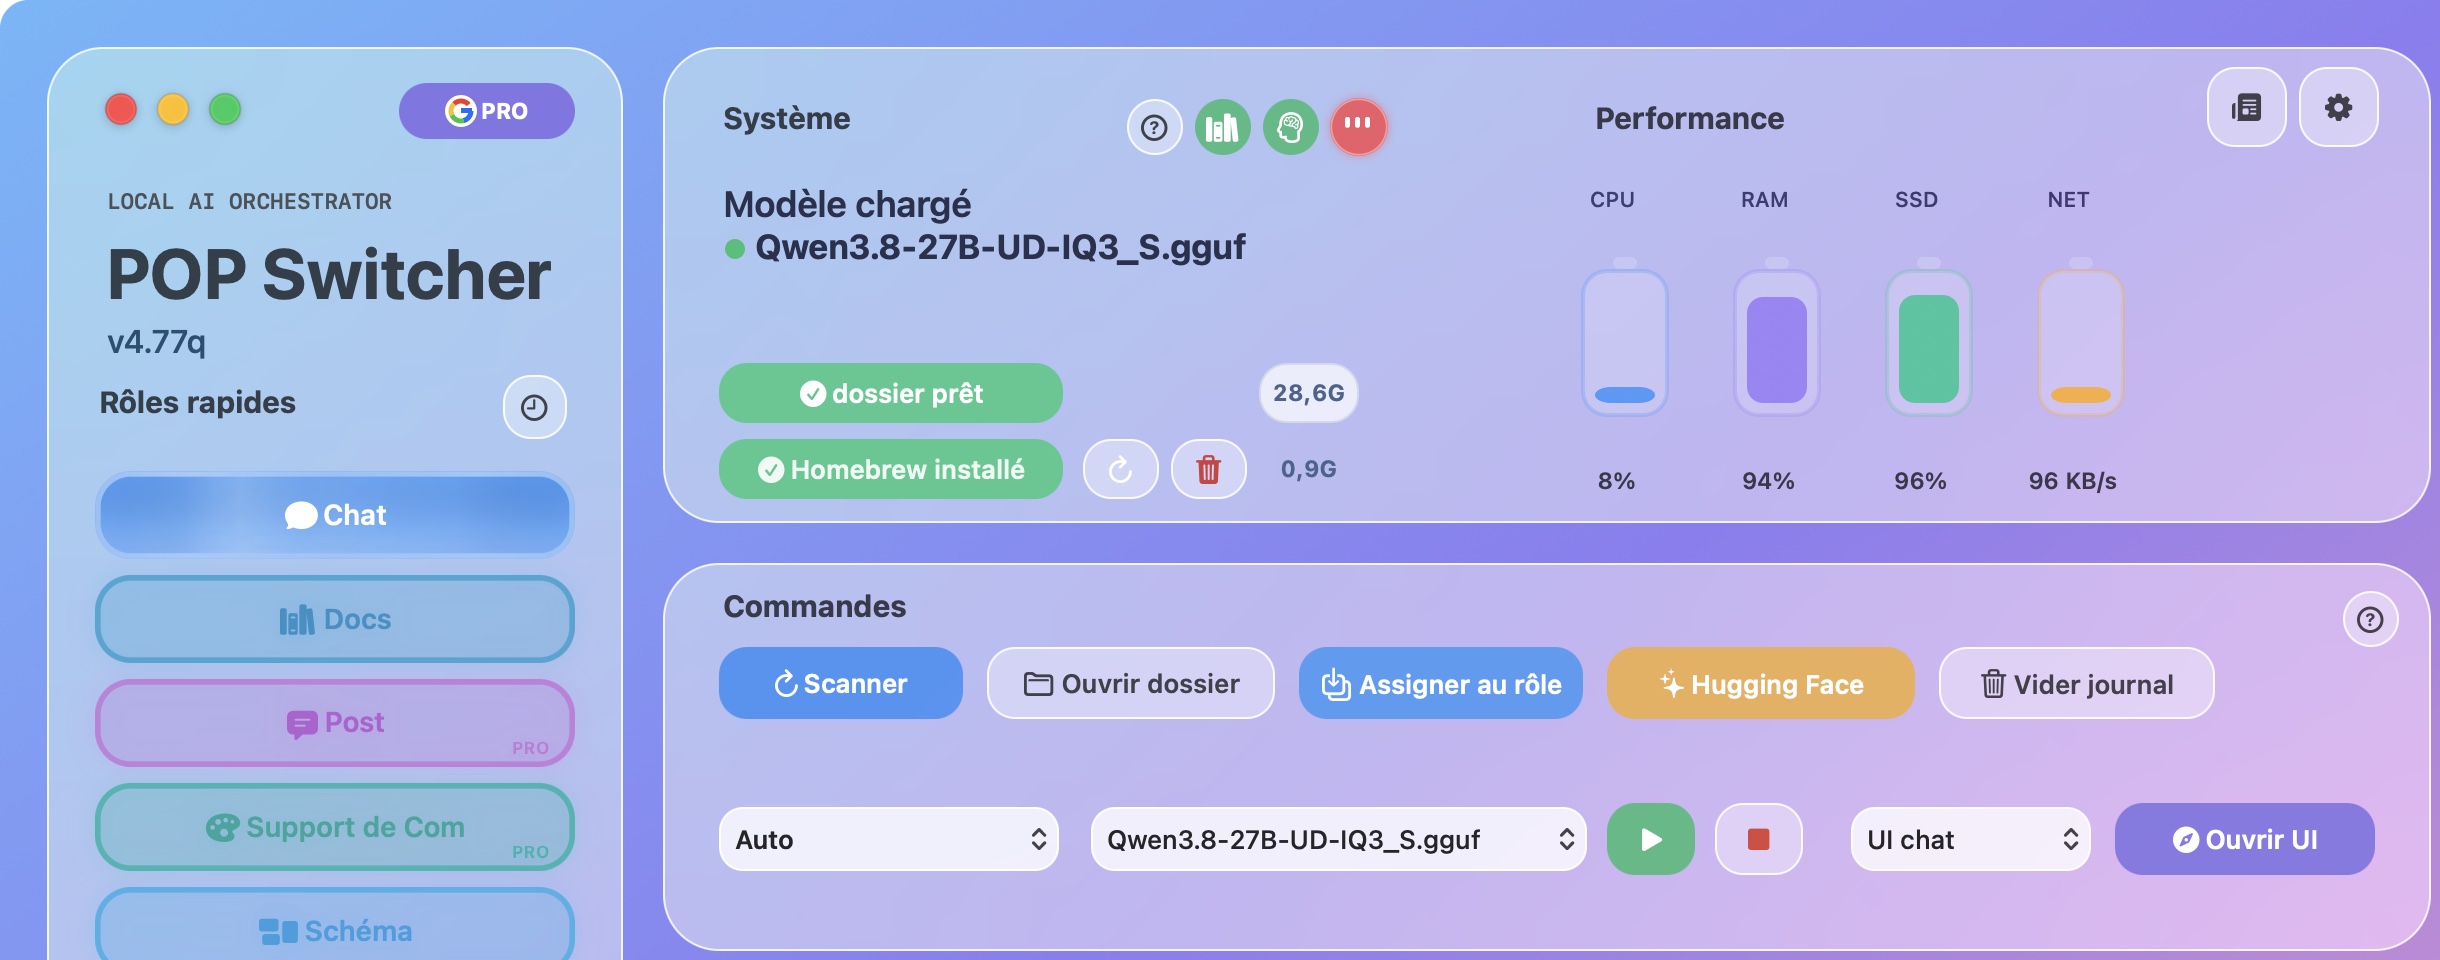
Dans POP, choisissez un fichier GGUF ou un modèle MLX pris en charge par votre moteur. Validez une conversation, puis un appel d’outil simple. Relevez ensuite la mémoire, le délai de première réponse et la vitesse de génération. Le guide GGUF aide à préparer cette étape.
Pour démarrer, examinez E4B avec un contexte mesuré. Pour un usage polyvalent, étudiez le compromis MoE du 26B-A4B. Pour le code et les agents, les résultats publiés de Qwen justifient un essai attentif. Le meilleur choix sera celui qui termine correctement vos tâches dans la mémoire et le temps disponibles.
Sources & repères
- Google — Gemma 4, architectures et benchmarks ↗
- Google — fiche Gemma 4 E4B ↗
- Google — fiche Gemma 4 26B-A4B ↗
- Qwen — fiche et protocoles Qwen3.8-27B ↗
- Artificial Analysis — Gemma 4 E4B ↗
- Artificial Analysis — Gemma 4 26B-A4B ↗
- Artificial Analysis — Qwen3.8-27B xhigh ↗
Article rédigé avec l’aide de l’IA, puis structuré pour le journal POP Switcher. Les caractéristiques annoncées sont attribuées à leurs sources. Les fonctions POP Switcher décrites sont rapprochées de la version observée.
Faites de l’IA votre outil
Découvrez une interface Mac pour vos modèles, vos documents et vos idées.
Essayer POP Switcher gratuitement ↗Prolongez l’exploration
 Comparatifs IA
IA sur Mac : Apple Intelligence et POP Switcher, quelles différences ?
Apple Intelligence et POP Switcher : comparez intégration aux apps, choix des modèles, rôles, documents, traitement local et confidentialité.
 IA locale sur Mac
Ollama vs LM Studio : choisir son serveur local et le relier à POP
Ollama ou LM Studio sur Mac : prérequis, API locales, modèles, confidentialité et raccordement à un rôle POP Switcher.